人工智能
-
Karpo开源System 1+System 2浏览器智能体:102项任务准确率89%,单任务模型成本约0.096美元
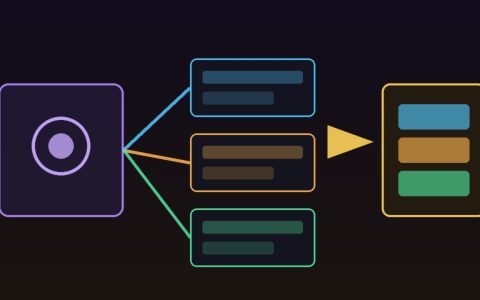
Karpo于11月21日开源浏览器智能体karpo-browser:通用大模型负责规划和读结果,决策模型Karpo Decision 27B Act负责逐步点选。在Browserbase Benchmark v2全部102道任务上,三次运行平均准确率89%,单任务平均201秒、0.096美元。
-
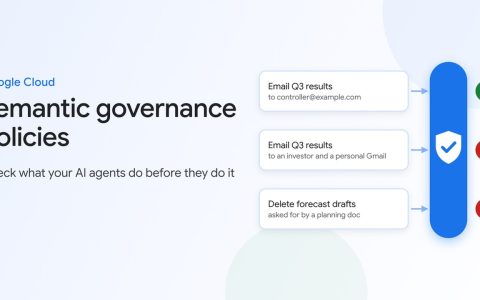
谷歌推出语义治理策略预览:智能体要调用工具,须先过明文规则和用户原意两道检查
11月20日,谷歌开发者博客宣布,Gemini 平台上的语义治理策略已进入预览。该机制在工具调用真正执行前,对照用明文写就的规则以及用户原本的意图进行检查,并由智能体之外的策略引擎作出裁决。
-
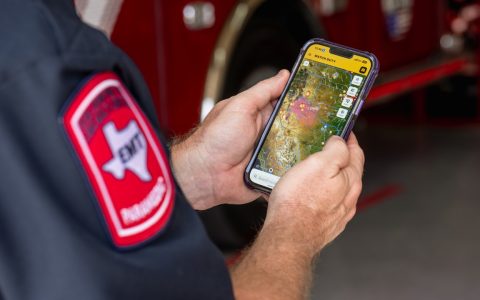
谷歌用Gemini把嘈杂的消防电台转成文字,Watch Duty能在30秒内发现新火情
11月20日,谷歌介绍与野火预警应用Watch Duty的合作:Gemini工具把充满杂音的消防电台转成可检索文字,劣质VHF音频词错误率从38%降至22.34%,并可在30秒内向报告员发出新调度提示。系统每天从约400路电台转写超过200小时语音。
-
MCP Events扩展进入Beta:智能体可以在没人提问时响应邮件、代码提交和故障告警
MCP官方文档将Events扩展列为Beta,设计提案SEP-3415已为Final。该扩展提供轮询、推送和Webhook三种投递方式,让智能体在无人提问时订阅上游事件。OpenAI文档显示,ChatGPT已在Work对话和dots中支持Webhook投递,但不支持轮询和流式推送。
-
Hugging Face推出harness adapters:Qwen3.8-27B在pi框架上Terminal-Bench得分从39%升至55%,平均token用量减半
Hugging Face于11月20日介绍为智能体框架训练的LoRA适配器。以Qwen3.8-27B为例,在pi框架的Terminal-Bench 2.1上,pass@1从39%升至55%,平均每题token从约2.9K降至1.5K。三个专科适配器还可合并使用,但换到很不同的评测循环后优势不再明显。
-
Hebbia测试GPT-6 Astra做金融研究:所需来源类型引用领先13.6个百分点,相关摘录占99.5%
OpenAI于11月20日发布客户案例称,金融研究平台Hebbia用预发布的GPT-6 Astra测试投研流程。在Hebbia的评分下,该模型在引用所需类型来源上比表现最好的对照模型高13.6个百分点,所引摘录中99.5%与问题相关,并满足97.9%的适用呈现要求。
-
Anthropic数学家称与Claude完成黎曼猜想的形式化证明,MIT独立内核复核已通过多项检查
11月20日,Anthropic数学家Levent Alpöge在个人网站发布说明,称自己与Claude合作,得到了黎曼猜想的证明,并认为同一方法可推广到广义黎曼猜想,相关论证已在Lean中完成形式化。麻省理工学院的Andrew Sutherland随后公开了独立复核进展:在11月20日22:05(UTC)的更新中,多项编译和独立内核检查已经通过,仍有部分对照流程在运行。
-
OpenAI加强对抗蒸馏防护:GPT-6.2 Astra被提取受保护推理的成功率从54.0%降到0.2%
OpenAI在11月20日的官方文章中介绍了针对对抗蒸馏的防护升级。公司把重点放在保护模型的中间推理过程,并在内部自适应评估里给出一组对照数字:针对GPT-6.2 Astra,从先前请求中提取受保护推理的平均攻击成功率,由GPT-6 Astra在原有防护下的54.0%降到了0.2%。
-
谷歌桌面搜索首页开始全球推送可收起侧栏,方便接着上次的AI Mode提问继续查
谷歌搜索产品副总裁Robby Stein于11月19日在X上宣布,桌面版Google首页正在全球推送可收起侧栏,用来查找并回到最近的AI搜索。多家科技媒体当天据此报道,这一改动是为了让不再“问一次就结束”的检索,更容易从上次停下的地方继续。
-
英伟达用Dynamo给强化学习训练减负:按缓存分流rollout,CoreWeave称权重更新最快可提速约15倍
英伟达于11月19日发表技术博客,介绍如何把推理服务框架Dynamo用作强化学习训练中的rollout服务层。它处在训练框架和推理工人之间,负责分流请求、分发更新后的权重,并在工人故障时把任务转到仍可用的算力上。