发生了什么
据RoboHot等11月18日的报道,浙江大学与宇树科技具身智能联合实验室等团队开源了预训练数据集Movens-5M,以及基于该数据训练的动作模型Movens-Zero。项目把互联网上的人类视频转成可供人形机器人学习的动作数据,并让同一套模型响应文本、RGB视频、语音和音乐四类输入,在宇树G1上展示全身动作生成与真机执行。
关键细节和数据
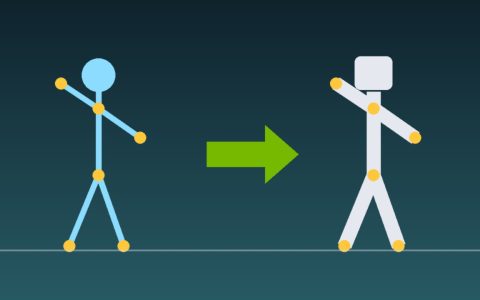
项目主页给出的规模数字是:约1500万条人体动作、500万条可执行动作、超过1万小时行为、逾10.8亿帧动作,覆盖297种细分动作类型和16类场景。数据处理流水线分为片段生成、质量筛选、语义标注、动作恢复和物理精修五步:先从原始视频切出连贯片段,再筛质量、补齐多模态说明,把人体动作重建并重定向到机器人,最后在闭环执行中验证是否稳定可跟踪。
Movens-Zero把理解模块和动作生成模块串起来。官方公开四档动作专家:S约6420万参数、M约1.879亿、L约5.001亿、XL约9.105亿。Scaling实验中,固定使用XL动作专家、把训练数据从Movens-5M的1%扩到100%时,文本与动作匹配得分R@3从12.72%升至62.57%;视频输入下关节位置误差MPJPE从132.82毫米降至40.90毫米;语音匹配从13.98%升至74.30%;音乐节拍对齐BeatAlign从0.23升至0.61;运动跟踪得分从0.21升至0.72。使用全部数据、把动作专家从S扩到XL时,验证集流匹配损失从0.487降至0.159,跟踪得分从0.18升至0.72。把训练数据从10%增到100%时,S档的R@3从6.34%升至10.30%,XL档则从24.92%升至62.57%。演示中,模型可响应“Dance some hip-hop”等文本、口头敬礼指令、音乐节奏,以及现场或网络视频示范,并以短片段滚动生成来保持动作连续。
为什么重要
人形机器人缺的不只是更大的控制策略,而是足够多、足够干净、又能在真机上跑得起来的动作数据。动作捕捉精确但难扩展,互联网视频量大却常含噪声和不可执行姿态。Movens把“重建、修复、重定向、仿真验证”做成可公开复用的数据引擎,并证明数据和动作专家一起放大时,匹配与跟踪指标还能继续抬升。
影响和展望
对研究者而言,这降低了做人形全身动作预训练的门槛;对厂商而言,它提示通用动作基础模型也可能像语言模型一样吃规模。仍需注意边界:公开演示集中在宇树G1,复杂接触操作、多人物场景和野外鲁棒性还要更多证据。数据集许可在Hugging Face上标注为“other”,商用与再分发前应单独核对授权条款。代码、分档模型和配套测试集Movens-Intent已在项目主页提供入口。对应论文《Movens-Zero: Scaling Humanoid Motion Foundation Models with Large-Scale Human Videos》的arXiv编号为2610.41877,摘要页显示论文在2026年10月30日左右提交;此次开源的是经过验证的数据集、分档权重和代码,把此前的研究方法变成可复用的公共资源。项目主页还提供一段约5分16秒的真机影片,覆盖现场与互联网视频、口头指令、音乐和文本提示等多种输入。
参考来源
发布者:极致前沿,转转请注明出处:https://www.veryin.com/4801.html